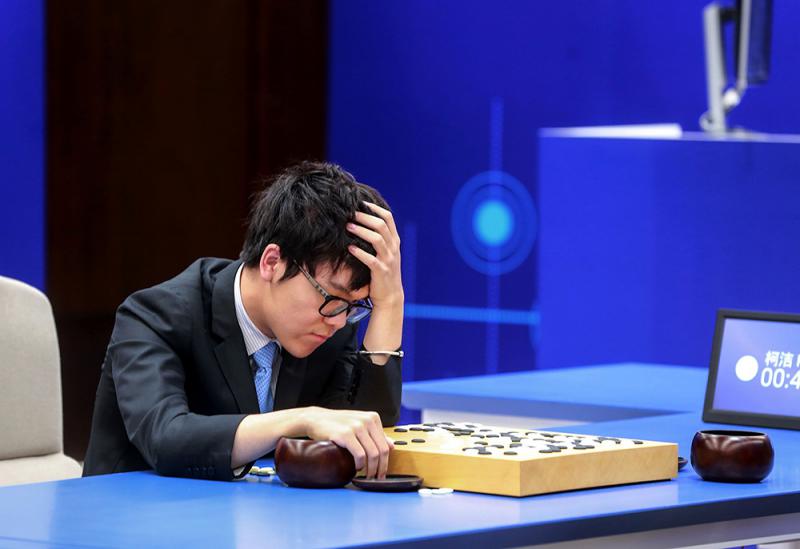
圖:中國九段棋手柯潔今年5月敗給AlphaGo 法新社
【大公報訊】綜合英國《金融時報》、日本經濟新聞、TechNews網站報道:谷歌旗下DeepMind的人工智能AlphaGo(阿爾法圍棋)因近年先後擊敗世界頂尖棋手而名聲大噪。DeepMind的探索沒有停止,如今新開發出最新一代AlphaGo Zero(阿爾法元程序),與此前版本最大的不同在於,它是在沒有任何人類示範的前提下「自學成才」,通過反覆與自己對弈,僅僅40天就成為了世界頂級高手。
世界頂尖棋手的養成,動輒需要數十年的訓練、磨礪,但AlphaGo Zero創造了一個紀錄:三天。
36小時自學成才
作為最複雜的雙人棋盤遊戲,圍棋在棋盤上排列組合的可能性比宇宙中的原子數還要多。AlphaGo Zero在僅知曉圍棋基本規則的基礎上,最初只是隨機落子,但通過與自己對弈數百萬次,自學三天後就發展出專屬全新棋步,很快以100比0的戰績擊敗上代AlphaGo,完勝人類三千年來累積的圍棋本領。
試驗40天後,AlphaGo Zero已與自己對弈約2900萬局,強大程度超過此前所有版本,甚至已經開始掌握人類未知的下法。美國圍棋協會主席安迪.奧肯說,它的一些判斷簡直「像謎一樣」。
AlphaGo在去年和今年分別擊敗著名韓國棋手李世石和中國棋手柯潔,震驚全球。不過人們普遍認為,人工智能雖強大,但僅僅處於人類知識的延長線上,離不開人類。然而這次已經不一樣。AlphaGo Zero亮相後,柯潔第一時間在微博做出回應,這位20歲的圍棋九段天才說,「一個純淨、純粹自我學習的AlphaGo是最強的,對於AlphaGo的自我進步來講……人類太多餘了。」結尾配上了一個悲傷的表情。
可望降低資料匯集成本
圍棋不像撲克或骰子一樣與機會有關,其局勢完全由棋子的位置決定。下圍棋需要佔據比對手更多的地盤,這個特徵也讓它非常容易受到AlphaGo所依賴的計算機模擬的影響。專家認為,除了「拋棄人類經驗」和「自我訓練」之外,AlphaGo Zero的另一亮點還在於採用了新算法。研究團隊為它開發了一種新的「強化學習」形式,將基於搜索的未來走法模擬與神經網絡相結合,來決定最有可能獲勝的招數。這一網絡隨着每次對弈,不斷更新和增強。
在很多情況下,獲得大量人類資料的成本過於高昂,DeepMind希望AlphaGo Zero的人工智能技術也能用在人類生活的其他方面,從大量數據中發現人類難以意識到的提升效率的方式,比如以人類的各種用電數據為基礎來調整電力供需,以及在人類力量難以解決的新材料開發、探究蛋白質生成機制等方面作出貢獻等等。