智元發佈GO- 3 Preview具身機器人模型 登頂三大權威評測榜單
2026-10-30 16:11:02 大公網 作者:曾萍
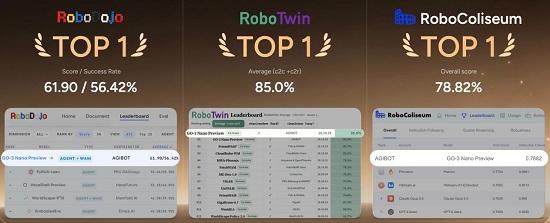
10月29日,智元機器人推出新一代具身基座模型GO- 3 Preview。當前大語言模型已經具備較強的文本推理能力,但機器人想要在現實世界完成抓取、裝配等實體工作,不僅需要「思考」,更要適配物理環境,處理物體接觸、位置變化等現實問題,這也是具身智能技術需要攻克的核心難題。在此背景下,GO- 3 Preview實現預訓練、後訓練、部署後全鏈路規模化學習,並且拿下RoboDojo、RoboTwin、RoboColiseum三大行業評測榜單第一名,該模型計劃在2026年底全面開源。
不同於傳統模型僅依靠前期數據訓練,智元提出,機器人智能不能只靠實驗室訓練數據,更要在真實作業場景中不斷積累經驗迭代優化。GO- 3 Preview依託全新的WRAM具身原生架構,打通任務理解、環境預判和實際動作輸出,機器人看懂指令之後,可以預判環境接下來的變化,再輸出適配現實場景的操作動作,整套學習分為預訓練、後訓練、部署後持續進化三個階段。
預訓練階段:打好基礎,實現陌生場景舉一反三
日常生活裏,同樣是拿起水杯,杯子的樣式、擺放位置千差萬別。如果機器人只會記住固定動作,遇到場景變化就容易失效。預訓練的目標,就是讓機器人掌握通用本領,面對沒見過的任務也可以快速上手。
GO- 3 Preview一方面吸收人類第一視角的操作視頻,學習人與物體交互的邏輯;另一方面採集機器人自身操作軌跡,建立視覺觀察、動作和物理結果之間的對應關係。
模型內部做了多項技術優化:簡化視覺信息處理,降低畫面數據運算壓力;先預判場景接下來會發生什麼,再規劃機器人動作;同時篩選合理的預判結果,讓預判和實際動作互相匹配。
經過預訓練之後,機器人無需額外調試,在家居、廚房、多機協作、靈巧操作等場景就可以完成全新任務。只要少量人為示範,還能挑戰煎餅果子製作、樂高拼裝這類步驟繁瑣、對精細度要求高的工作。
後訓練階段:虛實結合反覆練習,模擬覆盤提升實操水平
完成基礎學習,不等於機器人就能勝任複雜工作,就像人學會基礎動作後,依舊需要反覆練習打磨技巧。在後訓練環節,智元搭建混合訓練系統,結合真實機器人、仿真虛擬環境與環境推演工具開展訓練。
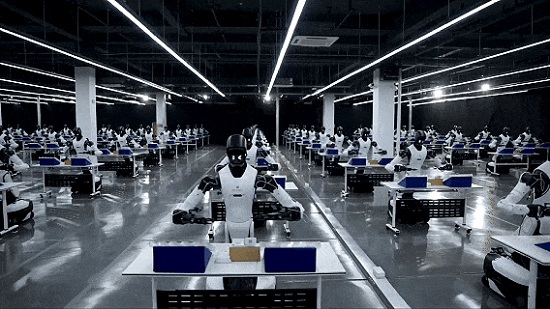
真實真機集羣可以實現羣體經驗共享。上百台機器人同步開展作業,成功的操作可以被全體機器人借鑑,失敗案例則標記出待優化的問題點,一台機器人踩過的坑,其他機器人也可以同步學習規避。
仿真虛擬環境能夠低成本創造大量現實中難復現的場景,反覆開展測試練習。同時藉助環境推演工具,機器人僅憑一段真實操作記錄,就可以模擬推演多種後續可能性,不用全部依靠真機試錯,通過「想象試錯」優化行動策略。
這套訓練模式已經得到驗證:桌面冰壺任務中,經過4小時迭代訓練,機器人操作水平已經超過普通測試人員;堆疊抽積木遊戲裏,機器人能夠連續抽出5塊積木,同時保證高塔不會倒塌。
部署上線:在真實工作中自我迭代,邊幹活邊升級
以往機器人落地後,如果遇到訓練時沒有見過的狀況,大多需要工程師人工修改代碼、補充數據,迭代效率較低。GO- 3 Preview希望改變這一模式,讓已經上崗的機器人,在實際工作過程裏持續自我優化。
智元搭建自進化框架,統一任務調用、執行、結果反饋的整套流程。機器人在工作中會自動記錄任務成敗案例,一方面把經驗保存下來,遇到相似任務直接參考過往教訓;另一方面把實際作業產生的操作數據用於模型更新,把實操收穫固化成機器人的固有能力。
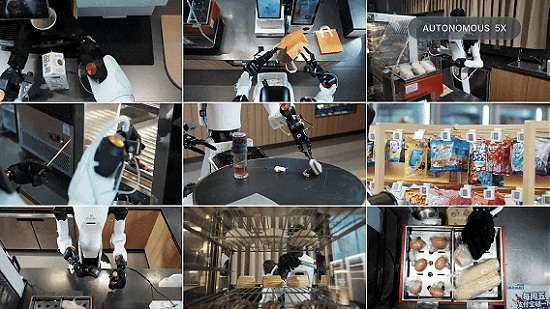
這套方案已經在商用機器人精靈G2上落地測試。該機器人在便利店執行真實業務,全程不需要人工實時介入調試。上線第一天完整任務完成率僅有28.6%,依靠持續積累實操經驗,5天后任務成功率提升至85.7%。以掛小掛鈎這一具體工作為例,機器人自己找到失敗原因,調整操作順序,任務成功率對比傳統調優方式提升17.7個百分點,並且能力可以持續上漲,不會輕易陷入性能瓶頸。這也是行業內少有的,脱離仿真實驗室,在真實商業場景完成機器人自主進化驗證的項目。
行業意義:打通全鏈路,探索實體AI規模化成長路徑
從早期GO- 1、GO- 2模型,到本次GO- 3 Preview發佈,智元持續推進具身智能技術迭代。大模型依靠海量數據實現能力躍升已經被市場驗證,但物理世界機器人如何複製規模化增長,一直是行業討論焦點。
GO- 3 Preview給出的思路,就是把學習貫穿模型的整個生命週期:預訓練搭建通用能力底座,後訓練通過虛實結合打磨實操技巧,部署後依託真實業務源源不斷獲取新經驗。當觀察、行動、反饋形成閉環,機器人就可以不斷拓寬能力邊界,推動人形機器人從實驗室走向真實的各類工作場景。